Clase 4: Model Training
A diferencia de un Modelo de Machine Learning, las Redes Neuronales se entrenan de manera progresiva (se espera una mejora en cada Epoch). Si nuestra Arquitectura es apropiada nosotros deberíamos esperar que el
Lossde nuestra red siempre disminuya. ¿Por qué?
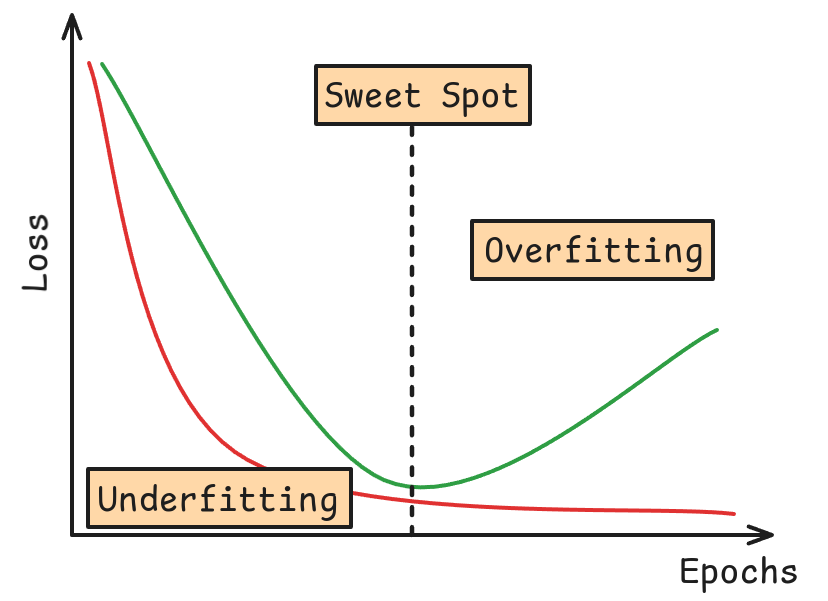
💡 Dado que el entrenamiento es progresivo, el modelo puede retomar su entrenamiento desde un set de pesos dados.
Probablemente el concepto más importante para determinar si un modelo tiene potencial o no. Corresponden a dos tipos de errores que pueden sufrir los modelos de ML.
Bias
Corresponde al sesgo, y tiene que ver con la diferencia entre el valor real y el valor predicho. Bajo sesgo implica una mejor predicción.
Variance
Corresponde a la varianza y tiene que ver con la dispersión de los valores predichos. Baja Varianza implica un modelo más estable y menos flexible.
En general hay que buscar el equilibrio entre ambos tipos de errores:
Se refiere al proceso de entrenar un modelo en una cierta porción de los datos, pero validar sus rendimiento y capacidad de generalización en un set de datos no vistos por el modelo al momento de entrenar.
¿Qué es la Generalización?
Los dos métodos más populares que se usan en Machine Learning son Holdout y K-Fold. Más métodos se pueden encontrar en los docs de Scikit-Learn.
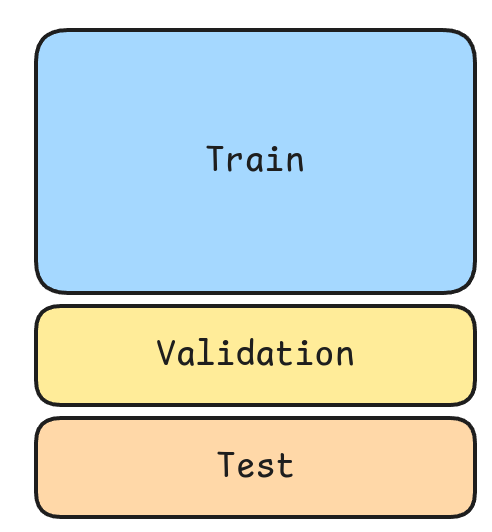
Debido a los volúmenes de datos utilizados, el esquema de validación más utilizado es el Holdout.
Train
Corresponde a la porción de utilizado para que el modelo aprenda.
Validation
Corresponde a la porción de datos no vistos por el modelo durante el entrenamiento. Se utiliza para medir el nivel de generalización del modelo.
Test
Se utiliza para evaluar reportando una métrica de diseño del Modelo.
A diferencia de un modelo de Machine Learning el proceso de validación del modelo se realiza en conjunto con el entrenamiento. Es decir, se entrena y valida el modelo Epoch a Epoch.
Nos referimos a la evaluación del modelo como la medición de la performance esperada por nuestro modelo. La Evaluación del Modelo se realiza en torno a una métrica definida a priori por el modelador. La métrica a utilizar está íntimamente ligada al problema a resolver.
Clasificación
Regresión
🤓
Las métricas presentadas son las básicas para clasificación y regresión. Existen otras más específicas según el campo:
🤔 Medir la performance de un modelo de Deep Learning se complica al usar Mini-Batch. ¿Por qué?
Es una librería de manipulación de Tensores especializada en Deep Learning. Provee principalmente, manipulación de tensores (igual que Numpy, pero en GPU), además de Autograd (calcula derivadas de manera automática).
Para poder comenzar a utilizarlo se requieren normalmente 3 imports:
👀
torch es donde se encuentran la mayoría de funciones básicas para manipular tensores.torch.nn es donde se encuentran los módulos necesarios para poder crear redes neuronales (neural networks). Cada módulo es una clase en Python.torch.nn.functional es donde se encontrarán utility functions además de versiones funcionales de elementos de torch.nn.👀 Una versión funcional es capaz de replicar la operación de un módulo pero no tiene la capacidad de almacenar los parámetros aprendidos.
Es posible realizar todas las operaciones básicas de manipulación de tensores con Pytorch. Algunos ejemplos:
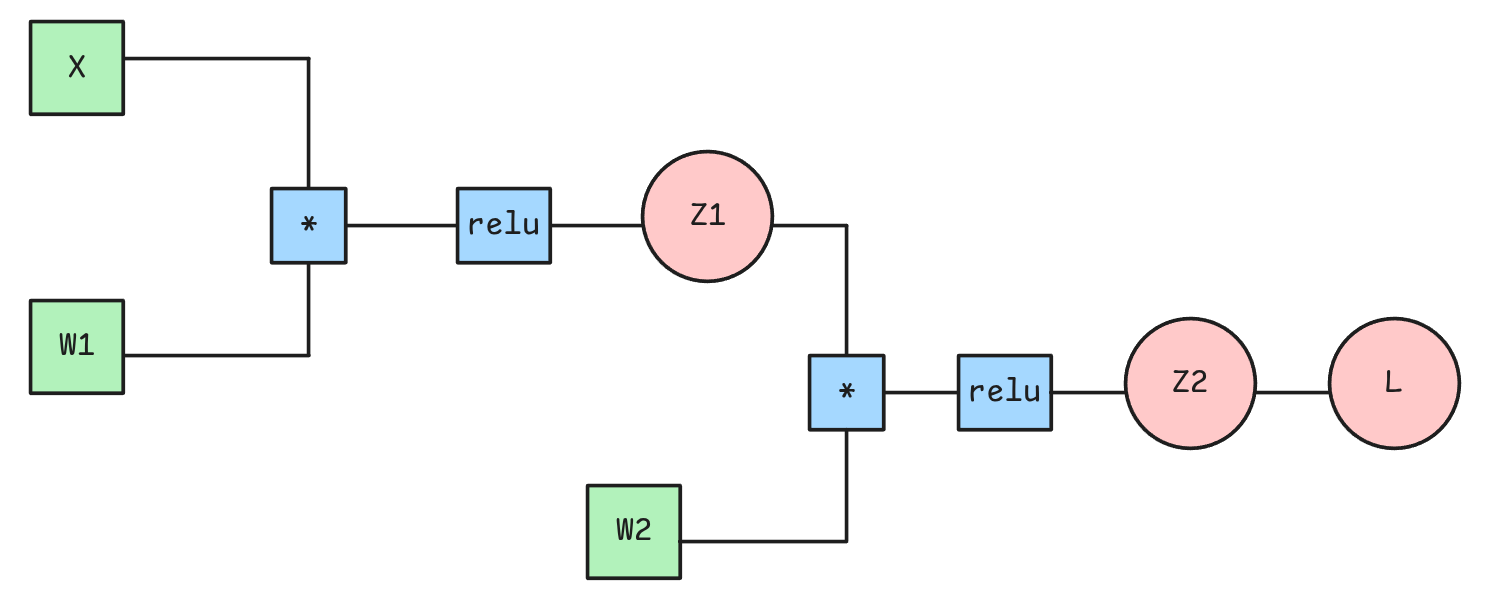
Adicionalmente, PyTorch cuenta con un motor de diferenciación automática llamado Autograd, que permite calcular derivadas automáticamente mediante un grafo computacional utilizando operaciones con tensores.
👀 Ojo: Las derivadas que nosotros ocupamos sólo tienen sentido porque son derivadas escalares (como por ejemplo el Loss).
import torch
import torch.nn as nn
import torch.nn.functional as F
X = torch.randint(0, 10, (5, 4), dtype=torch.float32).requires_grad_()
y = torch.randint(0, 3, (5,), dtype=torch.long)
W1 = torch.randint(0, 10, (4, 8), dtype=torch.float32).requires_grad_()
Z1 = torch.relu(X @ W1)
W2 = torch.randint(0, 10, (8, 3), dtype=torch.float32).requires_grad_()
Z2 = Z1 @ W2
loss = F.cross_entropy(Z2, y)
loss.backward() # Permite el cálculo de Gradientes
print("Gradiente de W1: ", W1.grad, sep="===============================\n")
print("Gradiente de W2: ", W2.grad, sep="===============================\n")Precaución
Autograd por defecto acumula los gradientes. Por lo tanto, antes de cada Forward Pass se deben reiniciar los gradientes a cero.
## Ejecutar esta celda varias veces.
# Luego descomentar la línea `W2.grad.zero_()` y volver a ejecutar la celda varias veces.
# ¿Qué sucede?
# W2.grad.zero_()
Z1 = torch.relu(X @ W1)
Z2 = Z1 @ W2
## Sólo necesario para calcular Gradientes Intermedios que no son Nodos Hoja.
Z2.retain_grad()
loss = F.cross_entropy(Z2, y)
loss.backward()
print("Segundo backward:")
print("Gradiente de W2: ", W2.grad, sep="===============================\n")Por ejemplo el Gradiente respecto a los Logits para un problema de Clasificación Multiclase es:
Pytorch posee una interfaz aún más potente que permite crear redes neuronales más complejas con mucho menos código y de manera más declarativa.
class NeuralNet(nn.Module):
def __init__(
self,
):
super().__init__()
self.fc1 = nn.Linear(4, 8, bias=False)
self.relu = nn.ReLU(inplace=True)
self.fc2 = nn.Linear(8, 3, bias=False)
## Descomentar para obtener resultados del ejemplo anterior
# self.fc1.weight.data = W1.T
# self.fc2.weight.data = W2.T
def forward(self, x):
x = self.fc1(x)
x = self.relu(x)
x = self.fc2(x)
return x
model = NeuralNet()
logits = model(X)
## Pytorch llama `criterion`
# a la fórmula de cálculo del Loss Function.
criterion = nn.CrossEntropyLoss()
loss = criterion(logits, y)Un clase en Pytorch permite crear redes más complejas y poseen 2 métodos principales:
Todas las clases deben heredar de nn.Module.
__init__():
super().__init__().forward():
Una capa en Pytorch
torch.nn.atributos:
.weight.data y .bias.data (para los pesos y bias respectivos).class MCModel(nn.Module):
def __init__(self, n_classes=3):
super().__init__()
self.mlp = MLP()
self.prediction = PredictionMC(n_classes=n_classes)
def forward(self, x):
x = self.mlp(x)
x = self.prediction(x)
return x
X = torch.randint(0, 10, (5, 4), dtype=torch.float32)
model_MC = MCModel(n_classes=4)
model_MC(X)Loss Function
Loss Function a utilizar le llamaremos criterion.Optimizer
optimizer y se importa desde torch.optim.lr (learning rate).La principal ventaja de frameworks como Pytorch es su ejecución en GPU, la cual ofrece una enorme capacidad de cómputo por la gran cantidad de núcleos.
🤓 Las GPUs usan CUDA (una variante compleja de C++), por lo que los errores suelen ser crípticos. Por ello se recomienda desarrollar en CPU y pasar a GPU solo cuando el código ya funcione correctamente y sea necesario entrenar.
🖥️ El código anterior es particularmente útil para plataformas como Google Colab donde se permite activar o desactivar el uso de GPU.
Pytorch posee varias estrategias para hacer más eficiente el entrenamiento de Redes Neuronales. Dentro de las estrategias más comunes está el entrenamiento en GPU en Mini Batches.
Pytorch Dataset
Corresponde a una clase que hereda de torch.utils.data.Dataset, la cual define la forma en que se cargan los datos. Su principal ventaja es que permite realizar una carga perezosa (lazy loading), es decir, los datos se leen únicamente en el momento en que son requeridos.
from torch.utils.data import Dataset
class ExampleDataset(Dataset):
def __init__(self, X, y):
## Definimos variables internas de la clase
self.X = X.to_numpy()
self.y = y.values
def __len__(self):
## Define la cantidad de muestras del dataset.
return len(self.X)
def __getitem__(self, idx):
return dict(
## Tranformarmos cada índice en Tensor de Floats.
x=torch.from_numpy(self.X)[idx].float(),
## Dependiendo del problema se pueden requerir otros data types
y=torch.from_numpy(self.y)[idx].long()
)
train_data = ExampleDataset(X_train, y_train)
val_data = ExampleDataset(X_val, y_val)__init__: Inicializa el dataset solicitando los datos requeridos.
__len__: Define como se calcula la cantidad de muestras del dataset.
__getitem__: Define qué devuelve el elemento \(i\) del dataset. Es decir train_data[i] o val_data[i].
Pytorch Dataloader
Corresponde a una clase que permite cargar los datos por batch. Además permite paralelizar la carga de datos utilizando múltiples workers y controlar aspectos como qué hacer con el último batch (si es que no es completo) o si es necesario mezclar los datos (shuffling). La instancia del Dataloader también es lazy.
Para entrenar en GPU es necesario que el modelo y los datos estén GPU.
Para pasar el modelo a la GPU se utiliza model.to(device).
Para pasar los datos a la GPU se utiliza X.to(device) o y.to(device).
epoch_loss = dict(train=[], val=[])
epoch_metric = dict(train=[], val=[])
model = Model()
model.to(device)
for e in range(epochs):
train_metric = MulticlassAccuracy().to(device)
val_metric = MulticlassAccuracy().to(device)
batch_loss = dict(train=[], val=[])
model.train()
for batch in train_loader:
X, y = batch["X"].to(device), batch["y"].to(device)
optimizer.zero_grad()
logits = model(X)
loss = criterion(logits, y)
loss.backward()
acc = train_metric(logits, y)
optimizer.step()
batch_loss["train"].append(loss.item())
tr_acc = train_metric.compute()
train_epoch_loss = np.mean(batch_loss["train"])
epoch_metric["train"].append(tr_acc.item())
model.eval()
with torch.no_grad():
for batch in val_loader:
X, y = batch["X"].to(device), batch["y"].to(device)
logits = model(X)
loss = criterion(logits, y)
batch_loss["val"].append(loss.item())
acc = val_metric(logits, y)
val_acc = val_metric.compute()
val_epoch_loss = np.mean(batch_loss["val"])
epoch_metric["val"].append(val_acc.item())
epoch_loss["train"].append(train_epoch_loss)
epoch_loss["val"].append(val_epoch_loss)👀 Detalles clave de este loop
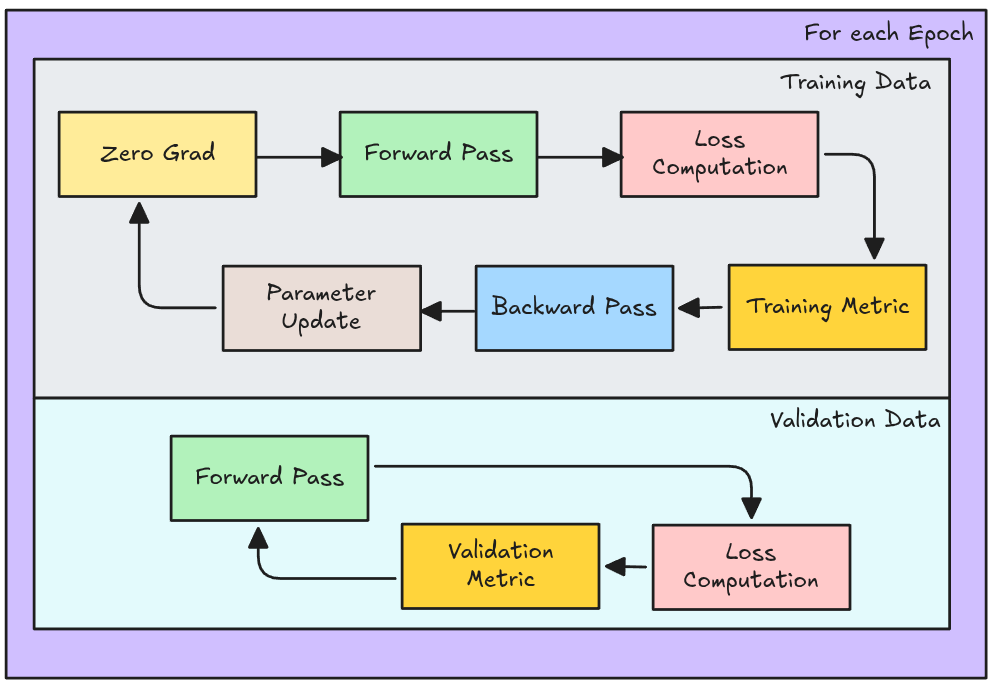
DataLoader en la GPU..compute()).Hasta ahora hemos asumido que las variables de entrada son numéricas. Pero en la práctica es muy común encontrarse con variables categóricas. En Deep Learning existen dos técnicas para lidiar con este tipo de variables: One-Hot-Encoding y el uso de Embeddings.
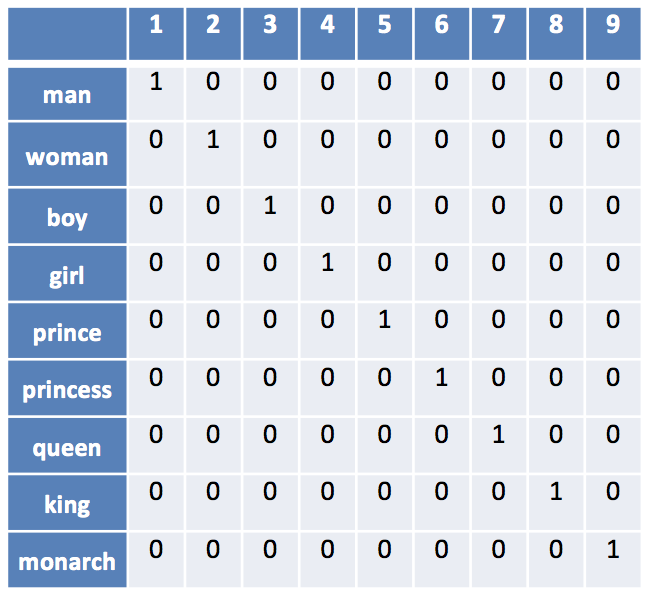
📋 One-Hot-Encoding
Permite una representación dispersa (sparse) de las variables categóricas. Consiste en crear una columna por cada categoría, y asignar un 1 o un 0 dependiendo si la instancia pertenece o no a dicha categoría.
Es una representación estática sin parámetros entrenables asociados.
Genera tantas columnas/features nuevas como categorías existan en la variable original. Por lo tanto, puede generar problemas de dimensionalidad si existen muchas categorías.
🗞️ Embeddings
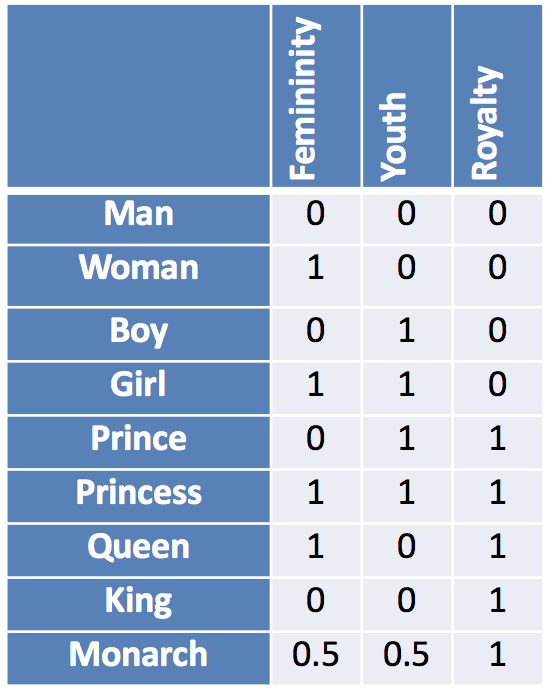
Un embedding es una representación numérica de un objeto (palabra, imagen, nodo, etc.) en un espacio vectorial de menor dimensión que captura sus características y relaciones de manera útil para un modelo de machine learning.
En lugar de trabajar con las categorías crudas, los embeddings convierten esos datos en vectores de números reales. De esta forma, objetos similares quedan representados por vectores cercanos.
Los vectores son aprendidos por el modelo durante el entrenamiento, de tal manera que la representación aprendida es la optima para el problema específico a resolver. Es decir, agrega parámetros entrenables al modelo.
One Hot Encoding
Se puede utilizar directamente en Pytorch utilizando F.one_hot(). En general esto se hace fuera del modelo y no es una capa entrenable.
Embedding
Este caso sí es una capa entrenable y se aplica en Pytorch como una capa más del modelo utilizando nn.Embedding().
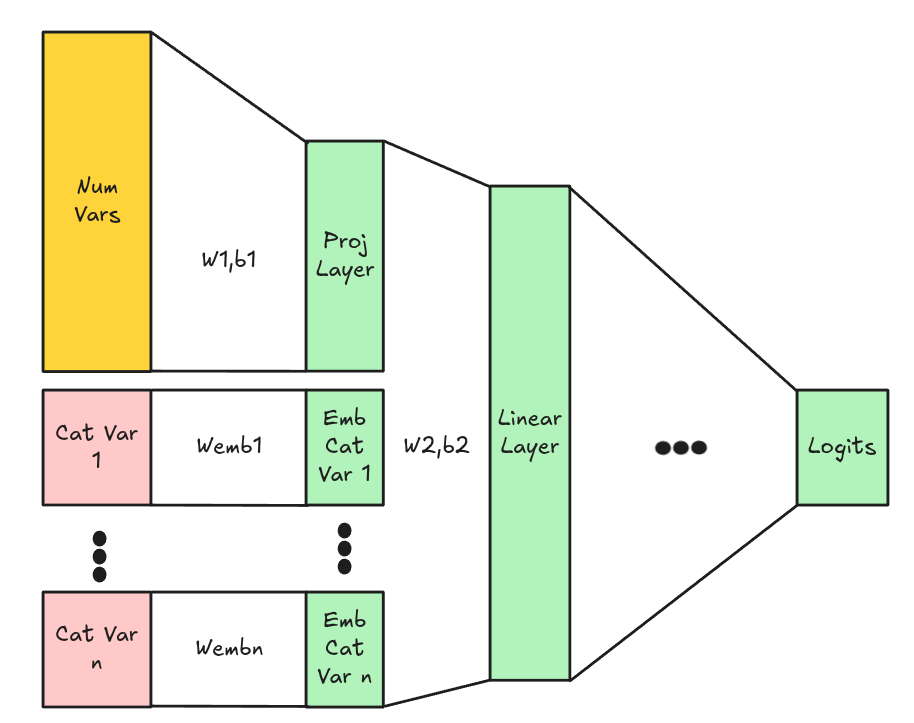
🤓 Projection Layer
En algunos casos se agrega una Projection Layer (capa lineal) en las variables numéricas a una nueva dimensión (Esto ya que el Embedding lleva a las variables categóricas a una dimensión diferente). Esto permite que el modelo aprenda una representación conjunta de las variables numéricas y categóricas. Luego las capas de proyección y embedding se concatenan y se pasan a las capas siguientes.
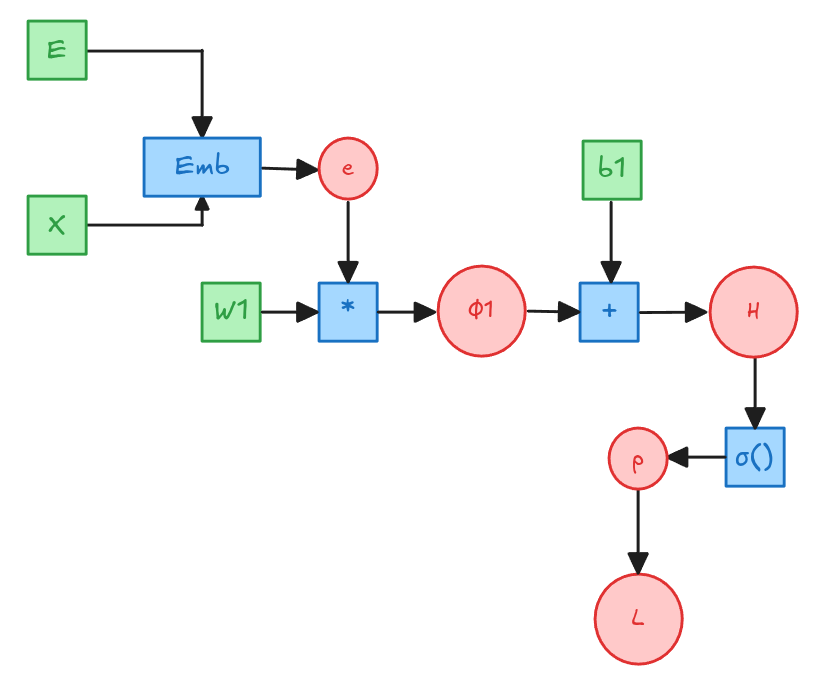
\[\frac{\partial L}{\partial Z} = \frac{1}{m} \cdot [p - y]\] \[\frac{\partial L}{\partial \phi_1} = \frac{1}{m} \cdot [p - y]\] \[\frac{\partial L}{\partial e} = \frac{\partial L}{\partial \phi_1} \cdot \frac{\partial \phi_1}{\partial e}= \frac{1}{m}[p-y] \cdot W_1^T \] \[\frac{\partial}{\partial E} = \frac{\partial L}{\partial e} \cdot \frac{\partial e}{\partial E} = \frac{1}{m} [p-y] \cdot W_1^T \cdot \frac{\partial e}{\partial E}\]
¿Cuánto vale \(\frac{\partial e}{\partial E}\)?
\[\frac{\partial e}{\partial E} = S^T\]
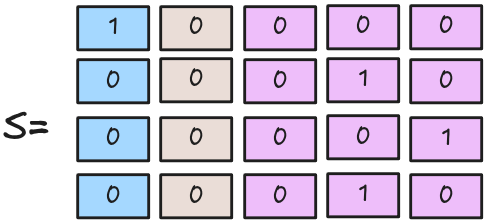
Donde \(S\) es es la matriz One-Hot-Encoding de tamaño \(m \times C\) donde C es el número de categorías.
\[ \phi_1 = \begin{bmatrix} 0.0300 \\ 0.1900 \\ 0.1600 \\ 0.1900 \end{bmatrix} \]
\[ Z = \begin{bmatrix} 0.1300 \\ 0.2900 \\ 0.2600 \\ 0.2900 \end{bmatrix} \]
\[ p = \begin{bmatrix} 0.5325 \\ 0.5720 \\ 0.5646 \\ 0.5720 \end{bmatrix} \]
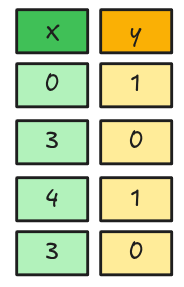
\[ \begin{align} \frac{\partial L}{\partial E} &= \frac{1}{m} S^T \cdot [p - y] \cdot W_1^T\\ &= \frac{1}{4} \cdot \begin{bmatrix} 1 & 0 & 0 & 0 \\ 0 & 0 & 0 & 0 \\ 0 & 0 & 0 & 0 \\ 0 & 1 & 0 & 1 \\ 0 & 0 & 1 & 0 \end{bmatrix} \cdot \left[\begin{bmatrix} 0.5325 \\ 0.5720 \\ 0.5646 \\ 0.5720 \end{bmatrix} - \begin{bmatrix} 1.0 \\ 0.0 \\ 1.0 \\ 0.0 \end{bmatrix} \right] \cdot \begin{bmatrix} 0.5 & -0.25 & 0.1 \end{bmatrix}\\ &=\begin{bmatrix} -0.0584 & 0.0292 & -0.0117 \\ 0.0000 & -0.0000 & 0.0000 \\ 0.0000 & -0.0000 & 0.0000 \\ 0.1430 & -0.0715 & 0.0286 \\ -0.0544 & 0.0272 & -0.0109 \end{bmatrix} \end{align} \]
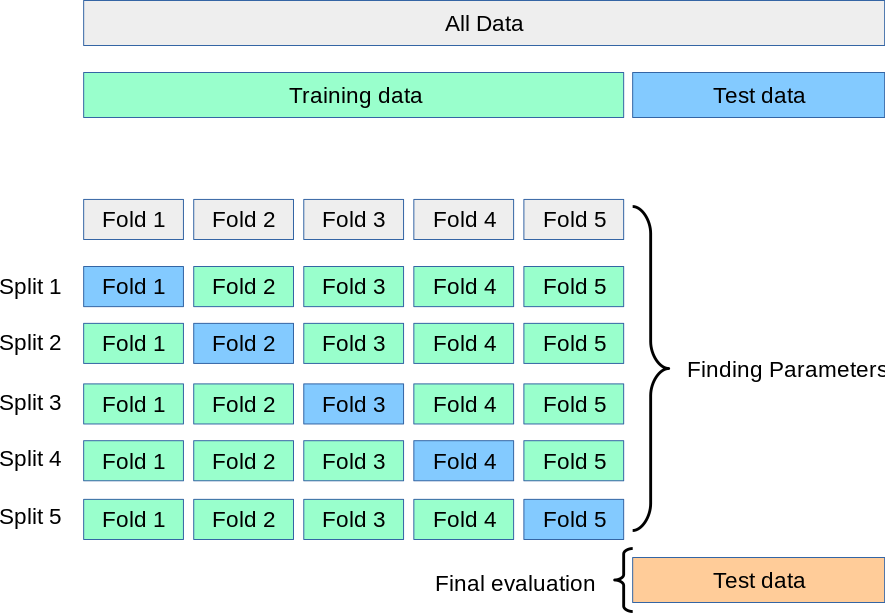
Corresponde al proceso de Holdout pero repetido \(K\) veces. No es tan utilizado en Deep Learning debido a los altos costos computacionales.